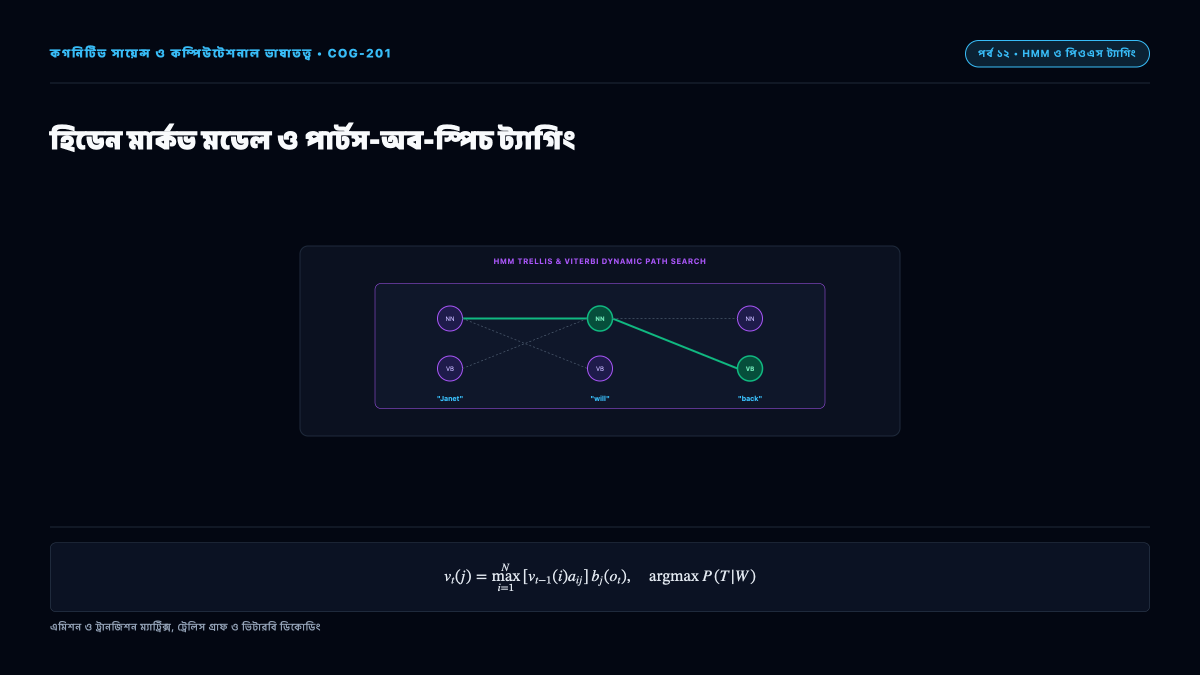
প্রাকৃতিক ভাষা প্রক্রিয়াকরণের প্রাথমিক ধাপ হলো পার্টস-অব-স্পিচ (POS) ট্যাগিং—অর্থাৎ বাক্যের প্রতিটি শব্দের ব্যাকরণিক পদ (বিশেষ্য, ক্রিয়া, বিশেষণ) নির্ভুলভাবে চিহ্নিত করা। যেহেতু বহু শব্দ একাধিক পদের ভূমিকা পালন করতে পারে, তাই সম্ভাব্যতাভিত্তিক ভাষাতত্ত্বে একে হিডেন মার্কভ মডেলের (HMM) সাহায্যে সর্বোত্তম স্টেট ডিকোডিং সমস্যা হিসেবে সমাধান করা হয়।
১. সিকোয়েন্স লেবেলিং ও ব্যাকরণিক দ্ব্যর্থকতা
একটি বাক্যে প্রদর্শিত শব্দ অনুক্রম (W = (w_1, dots, w_T))-এর জন্য সবচেয়ে সম্ভাব্য পদ অনুক্রম (hat{T}) খুঁজে বের করতে বেইজের উপপাদ্য প্রয়োগ করা হয়:
[
hat{T} = argmax_T P(W mid T) P(T)
]
২. হিডেন মার্কভ মডেলের (HMM) কাঠামো
HMM একটি দ্বৈত সম্ভাবনামূলক প্রক্রিয়া যেখানে ব্যাকরণিক ট্যাগগুলো হলো লুকায়িত অবস্থা (Hidden States) এবং মুখের শব্দগুলো হলো তাদের দৃশ্যমান এমিশন (Emissions)। HMM-এর দুটি মূল উপাদান:
ট্রানজিশন সম্ভাবনা ((a_{ij})): একটি পদের পর আরেকটি পদ আসার সম্ভাবনা ((P(t_k mid t_{k-1})))। যেমন বিশেষ্যের পর ক্রিয়া আসার সম্ভাবনা।
এমিশন সম্ভাবনা ((b_j(w_k))): কোনো নির্দিষ্ট ব্যাকরণিক পদ থেকে একটি নির্দিষ্ট শব্দ উচ্চারিত হওয়ার সম্ভাবনা ((P(w_k mid t_k)))।
যদি ৪৫টি ট্যাগ এবং ২০টি শব্দ থাকে, তবে সম্ভাব্য ট্যাগের বিন্যাস সংখ্যা দাঁড়ায় (45^{20} approx 10^{33})—যা এককভাবে পরীক্ষা করা অসম্ভব।
ভিটারবি অ্যালগরিদম (Viterbi Algorithm) ডায়নামিক প্রোগ্রামিং প্রয়োগ করে বহুপদী সময়ে ((mathcal{O}(T cdot N^2))) বিশ্বব্যাপী সর্বোত্তম ট্যাগ সিকোয়েন্স খুঁজে বের করে:
ইনডাকশন ধাপ: প্রতিটি সময় ধাপে সর্বোচ্চ সম্ভাব্যতার মান সংরক্ষণ করা হয়:
[
v_t(j) = max_{i=1}^N left[ v_{t-1}(i) a_{ij}
ight] b_j(w_t)
]
ব্যাকপয়েন্টার সংরক্ষণ: প্রতিটি ধাপে কোন আগের পথ থেকে সর্বোচ্চ মান এসেছে তা লিখে রাখা হয়।
ব্যাকট্র্যাকিং: বাক্যের শেষ শব্দ থেকে পিছন দিকে ফিরে এসে সম্পূর্ণ বাক্যের নির্ভুল ট্যাগ অনুক্রম উদ্ধার করা হয়।
ভিটারবি অ্যালগরিদমের এই নিখুঁত গাণিতিক ভিত্তিই কম্পিউটারকে মানুষের ভাষা ৯৭ শতাংশেরও বেশি নির্ভুলতায় স্বয়ংক্রিয়ভাবে পদবিন্যাস করার ক্ষমতা দেয়।
Share:
শাকিল মাহমুদ সজল
সফটওয়্যার প্রকৌশলী ও লেখক, ঢাকা, বাংলাদেশ। কম্পিউটার বিজ্ঞান, পদার্থবিজ্ঞান, ইতিহাস ও ভাবনার সমন্বয়ে ব্যক্তিগত নোট ও প্রবন্ধ সংকলন।
Editorial Dispatch
Curiosity & Articles Delivered to Your Inbox
Receive thoughtful articles on software architecture, physical sciences, history, and systems. No algorithms, no sponsors, no noise.
আন্তঃসম্পর্কিত জ্ঞানচর্চা ও পাঠপরিক্রমা কগনিটিভ সায়েন্স ও কম্পিউটেশনাল ভাষাতত্ত্ব→পদার্থবিজ্ঞানের মহাবিকাশ
চিন্তার ধারাবাহিকতা: সংযুক্ত বিষয় ও সংকলন
কোয়ান্টাম বলবিদ্যা ও গতিবিদ্যার পর এবার পা রাখুন ১৩.৮ বিলিয়ন বছরের মহাজাগতিক রূপরেখায় — নক্ষত্রের জন্ম ও গ্যালাক্সির বিবর্তন থেকে মহাবিশ্বের ভবিষ্যৎ।
গ্যালিলিওর গতিবিদ্যা ও নিউটনের মহাকর্ষ থেকে শুরু করে ম্যাক্সওয়েল, আইনস্টাইন, কোয়ান্টাম বলবিদ্যা এবং স্থান-কালের একীভূত কোয়ান্টাম গ্র্যাভিটির মহাকাব্যিক সন্ধান।
প্রস্তাবিত প্রবেশদ্বার ও গুরুত্বপূর্ণ মাইলফলক পর্বসমূহ:
বিশ্বব্যাপী সকল পাঠক, গবেষক ও শিক্ষার্থীদের জন্য উন্মুক্ত। গুগল বা যেকোনো ব্যক্তিগত ইমেইল দিয়ে সুরক্ষিতভাবে সাইন ইন করে পাঠ্যক্রমের অগ্রগতি সিঙ্ক ও চূড়ান্ত পরীক্ষায় অংশ নিন।
অথবা যেকোনো ইমেইল দিয়ে প্রবেশ করুন
🎓
Enrolled Academic Curricula (38 Disciplines)
The Great Equations (MATH-101)20 Parts • Mathematical Physics & Epistemology
The Story of Physics (PHYS-101)20 Parts • Classical & Modern Theoretical Physics
The Universal Chronicle (COSM-101)20 Parts • Astrophysics & Big History Cosmology
The Evolutionary Odyssey (BIOL-101)20 Parts • Paleobiology, Genetics & Macroevolution
The Story of Consciousness (PHIL-101)20 Parts • Cognitive Neuroscience & Philosophy of Mind
The History of Computing and AI (COMP-101)20 Parts • Computer Architecture & Machine Intelligence
The History of Bengal (HIST-101)20 Parts • Regional Historiography & Geopolitical Economy
The Epic of Human Civilization (CIV-101)20 Parts • World History & Civilizational Anthropology
The Evolution of Money & Markets (ECON-101)20 Parts • Monetary History, Central Banking & Macroeconomics
The Story of Chemistry (CHEM-101)20 Parts • Molecular Sciences, Quantum Bonding & Nanotechnology
The Story of Genetics (GEN-101)20 Parts • Molecular Biology, Genomics & Synthetic Life
The History of Philosophy (PHIL-101)20 Parts • Epistemology, Classical Metaphysics & Continental Thought
Game Theory & Mechanism Design (GAME-101)20 Parts • Strategic Interaction, Mechanism Design & Algorithmic Economics