গভীর নিউরাল নেটওয়ার্কের উত্থানের পূর্বে পরিসংখ্যানিক ভাষা মডেল (Statistical Language Modeling) ছিল স্পিচ রিকগনিশন, মেশিন অনুবাদ ও সার্চ ইঞ্জিনের মূল মেরুদণ্ড। মার্কভ চেইনের মাধ্যমে শব্দের অনুক্রমের সম্ভাবনা পরিমাপ এবং শূন্য-গণনা সংকট নিরসনে নেসার-নে স্মুথিংয়ের উদ্ভাবন পরিসংখ্যানিক ভাষাতত্ত্বের এক অবিস্মরণীয় মাইলফলক।
১. ভাষা মডেলের লক্ষ্য ও সম্ভাবনার চেইন রুল
একটি ভাষা মডেল যেকোনো বাক্য বা শব্দ অনুক্রমের সামগ্রিক সম্ভাবনা (P(w_1, w_2, dots, w_N)) গণনা করে। সম্ভাবনার সার্বজনীন চেইন রুল প্রয়োগ করলে দাঁড়ায়:
৩. শূন্য সম্ভাবনা সংকট ও পারপ্লেক্সিটি (Perplexity)
যেহেতু সম্ভাব্য শব্দের জোড়ার সংখ্যা বিশাল ((sim 10^{10})), তাই যেকোনো প্রশিক্ষণ ডেটাসেটেও অনেক সঠিক ব্যাকরণিক শব্দের বিগ্ৰাম অনুপস্থিত থাকে ((C = 0))। যদি কোনো টেস্ট বাক্যে একটিমাত্র অপরিচিত বিগ্ৰাম থাকে, তবে গুণফলের কারণে সম্পূর্ণ বাক্যের সম্ভাবনা শূন্য হয়ে যায় ((P = 0)), এবং মডেলের পারপ্লেক্সিটি (Perplexity) অসীমে পৌঁছায়।
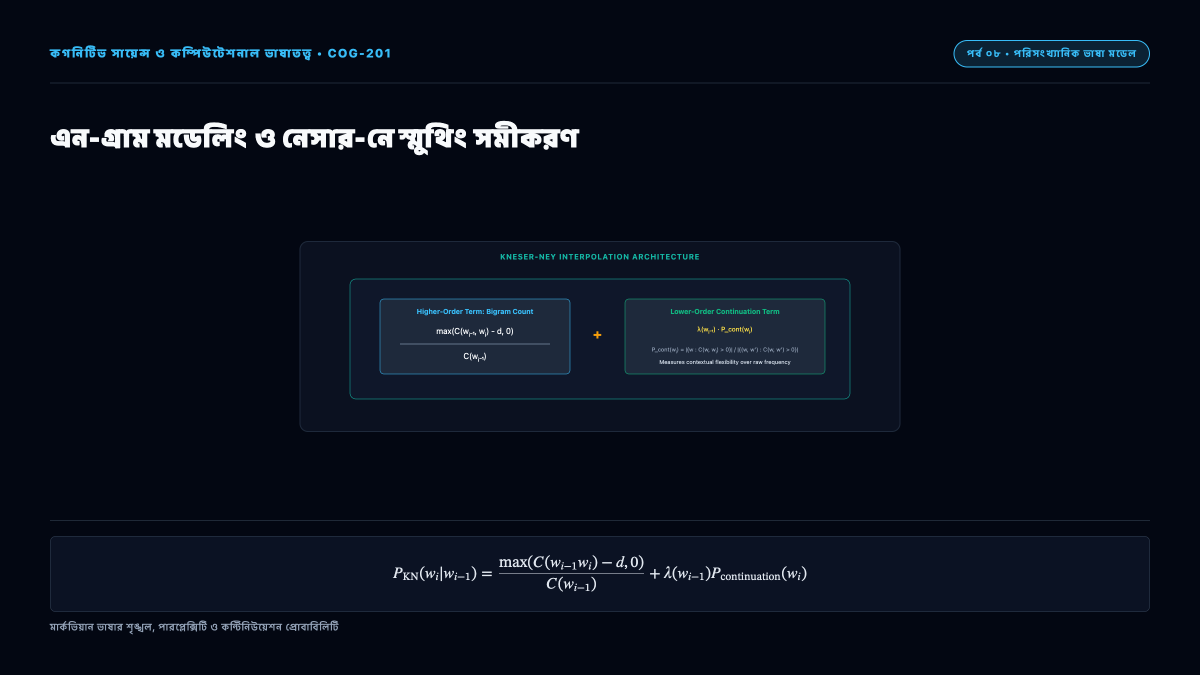
এই সমস্যা সমাধানে পরিচিত শব্দের থেকে সামান্য সম্ভাবনা কেটে নিয়ে অপরিচিত শব্দে বন্টন করা হয়। ১৯৯৫ সালে নেসার ও নে যে যুগান্তকারী পদ্ধতি আবিষ্কার করেন তার মূল স্তম্ভ দুটি:
অ্যাবসোলিউট ডিসকাউন্টিং: প্রতিটি পরিচিত শব্দ থেকে একটি ধ্রুবক মান (d) বিয়োগ করা হয়:
[
rac{max(C(w_{i-1}, w_i) – d, 0)}{C(w_{i-1})}
]
কন্টিনিউয়েশন প্রোবাবিলিটি: ব্যাকঅফ স্তরে কোনো শব্দের একক ফ্রিকোয়েন্সির বদলে শব্দটি কতটি ভিন্ন ভিন্ন প্রেক্ষাপটের পেছনে আসতে পারে ((P_{ ext{continuation}})) তা গণনা করা হয়।
যেমন “সান ফ্রান্সিসকো”-তে “ফ্রান্সিসকো” শব্দটি বারবার আসলেও এটি কেবল “সান”-এর পরেই বসে। কিন্তু “বই” বা “মানুষ” শব্দটি বহু ভিন্ন শব্দের পরে বসতে পারে, ফলে নতুন পরিস্থিতিতে এদের বসার সম্ভাবনা বেশি। এই বাস্তবসম্মত পরিসংখ্যানিক যুক্তিই নেসার-নে স্মুথিংকে এন-গ্রাম মডেলিংয়ের সেরা মানদণ্ড করেছে।
Share:
শাকিল মাহমুদ সজল
সফটওয়্যার প্রকৌশলী ও লেখক, ঢাকা, বাংলাদেশ। কম্পিউটার বিজ্ঞান, পদার্থবিজ্ঞান, ইতিহাস ও ভাবনার সমন্বয়ে ব্যক্তিগত নোট ও প্রবন্ধ সংকলন।
Editorial Dispatch
Curiosity & Articles Delivered to Your Inbox
Receive thoughtful articles on software architecture, physical sciences, history, and systems. No algorithms, no sponsors, no noise.
আন্তঃসম্পর্কিত জ্ঞানচর্চা ও পাঠপরিক্রমা কগনিটিভ সায়েন্স ও কম্পিউটেশনাল ভাষাতত্ত্ব→পদার্থবিজ্ঞানের মহাবিকাশ
চিন্তার ধারাবাহিকতা: সংযুক্ত বিষয় ও সংকলন
কোয়ান্টাম বলবিদ্যা ও গতিবিদ্যার পর এবার পা রাখুন ১৩.৮ বিলিয়ন বছরের মহাজাগতিক রূপরেখায় — নক্ষত্রের জন্ম ও গ্যালাক্সির বিবর্তন থেকে মহাবিশ্বের ভবিষ্যৎ।
গ্যালিলিওর গতিবিদ্যা ও নিউটনের মহাকর্ষ থেকে শুরু করে ম্যাক্সওয়েল, আইনস্টাইন, কোয়ান্টাম বলবিদ্যা এবং স্থান-কালের একীভূত কোয়ান্টাম গ্র্যাভিটির মহাকাব্যিক সন্ধান।
প্রস্তাবিত প্রবেশদ্বার ও গুরুত্বপূর্ণ মাইলফলক পর্বসমূহ:
বিশ্বব্যাপী সকল পাঠক, গবেষক ও শিক্ষার্থীদের জন্য উন্মুক্ত। গুগল বা যেকোনো ব্যক্তিগত ইমেইল দিয়ে সুরক্ষিতভাবে সাইন ইন করে পাঠ্যক্রমের অগ্রগতি সিঙ্ক ও চূড়ান্ত পরীক্ষায় অংশ নিন।
অথবা যেকোনো ইমেইল দিয়ে প্রবেশ করুন
🎓
Enrolled Academic Curricula (38 Disciplines)
The Great Equations (MATH-101)20 Parts • Mathematical Physics & Epistemology
The Story of Physics (PHYS-101)20 Parts • Classical & Modern Theoretical Physics
The Universal Chronicle (COSM-101)20 Parts • Astrophysics & Big History Cosmology
The Evolutionary Odyssey (BIOL-101)20 Parts • Paleobiology, Genetics & Macroevolution
The Story of Consciousness (PHIL-101)20 Parts • Cognitive Neuroscience & Philosophy of Mind
The History of Computing and AI (COMP-101)20 Parts • Computer Architecture & Machine Intelligence
The History of Bengal (HIST-101)20 Parts • Regional Historiography & Geopolitical Economy
The Epic of Human Civilization (CIV-101)20 Parts • World History & Civilizational Anthropology
The Evolution of Money & Markets (ECON-101)20 Parts • Monetary History, Central Banking & Macroeconomics
The Story of Chemistry (CHEM-101)20 Parts • Molecular Sciences, Quantum Bonding & Nanotechnology
The Story of Genetics (GEN-101)20 Parts • Molecular Biology, Genomics & Synthetic Life
The History of Philosophy (PHIL-101)20 Parts • Epistemology, Classical Metaphysics & Continental Thought
Game Theory & Mechanism Design (GAME-101)20 Parts • Strategic Interaction, Mechanism Design & Algorithmic Economics