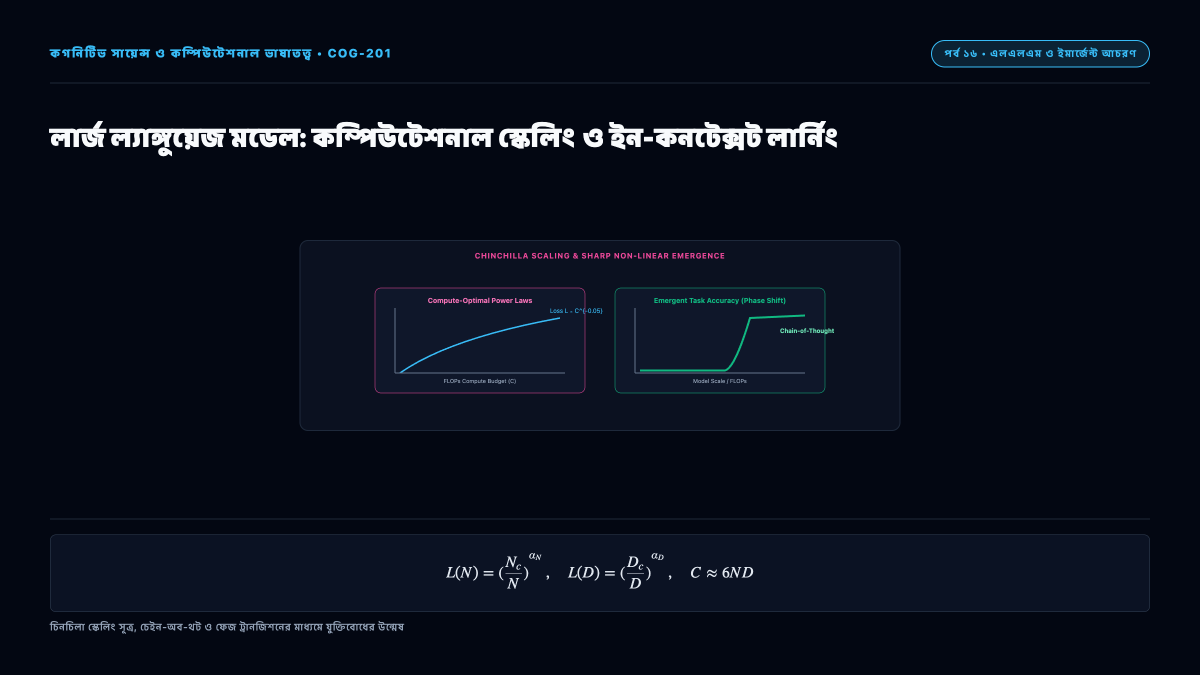
ট্রান্সফরমার আর্কিটেকচারকে যখন কোটি কোটি প্যারামিটার এবং ট্রিলিয়ন ট্রিলিয়ন টোকেনের বিশাল ডেটাসেটে প্রশিক্ষণ দেওয়া হয়, তখন পরিমাণগত সম্প্রসারণের ফলে গুণগত কগনিটিভ রূপান্তর ঘটে। লার্জ ল্যাঙ্গুয়েজ মডেল (LLM) কেবল পরিসংখ্যানিক টেক্সট প্রেডিক্টরের গণ্ডি ছাড়িয়ে ইন-কনটেক্সট লার্নিং ও ধারাবাহিক যৌক্তিক চিন্তন পরিচালনাকারী বহুমুখী বুদ্ধিবৃত্তিক ইঞ্জিনে রূপান্তরিত হয়।
১. কজাল অটোরিগ্রেসিভ প্রশিক্ষণ
আধুনিক ডিকোডার-অনলি লার্জ ল্যাঙ্গুয়েজ মডেলগুলো পরবর্তী শব্দ বা টোকেন অনুমানের ক্রস-এন্ট্রপি লস কমানোর মাধ্যমে প্রশিক্ষিত হয়:
ডিপমাইন্ডের ২০২২ সালের গবেষণায় প্রমাণিত হয় যে কম্পিউটেশনাল বাজেটের সর্বোচ্চ সদ্ব্যবহারের জন্য মডেলের আকার ((N)) এবং ডেটাসেটের টোকেন সংখ্যা ((D)) উভয়কে সমান অনুপাতে বৃদ্ধি করতে হয়:
অর্থাৎ মডেলের প্যারামিটার দ্বিগুণ করলে ডেটাসেটের আকারও দ্বিগুণ করতে হয়। এই গাণিতিক সূত্র আধুনিক উচ্চ-দক্ষতাসম্পন্ন এলএলএম তৈরির মূল দিকনির্দেশক।
৩. ইন-কনটেক্সট লার্নিং (In-Context Learning)
এলএলএম-এর সবচেয়ে চমৎকার বৈশিষ্ট্য হলো কোনো ওজন বা প্যারামিটার পরিবর্তন না করেই কেবল প্রম্পটে কয়েকটি উদাহরণ দিলে মডেল তাৎক্ষণিকভাবে সম্পূর্ণ নতুন কোনো কাজ শিখে ফেলতে পারে। গবেষণায় দেখা গেছে সেলফ-অ্যাটেনশন স্তরগুলো ফরওয়ার্ড পাসের ভেতরেই এক ধরণের অবচেতন গ্র্যাডিয়েন্ট ডিসেন্ট অ্যালগরিদম কার্যকর করে।
৪. ইমার্জেন্ট ক্ষমতা ও চেইন-অব-থট (CoT)
মডেলের আকার একটি নির্দিষ্ট স্কেল অতিক্রম করলে হঠাৎ করে এমন সব ক্ষমতা দৃশ্যমান হয় যা ছোট মডেলে অনুপস্থিত ছিল—একে ইমার্জেন্ট ক্ষমতা (Emergent Abilities) বলা হয়। “ধাপে ধাপে চিন্তা করো” (Chain-of-Thought) প্রম্পট ব্যবহারের মাধ্যমে মডেল জটিল গাণিতিক ও যৌক্তিক সমস্যার প্রতিটি ধাপ আলাদা টোকেন হিসেবে প্রকাশ করে মানুষের সিস্টেম ২-এর মতো গভীর চিন্তন প্রক্রিয়া সম্পাদন করতে পারে।
Share:
শাকিল মাহমুদ সজল
সফটওয়্যার প্রকৌশলী ও লেখক, ঢাকা, বাংলাদেশ। কম্পিউটার বিজ্ঞান, পদার্থবিজ্ঞান, ইতিহাস ও ভাবনার সমন্বয়ে ব্যক্তিগত নোট ও প্রবন্ধ সংকলন।
Editorial Dispatch
Curiosity & Articles Delivered to Your Inbox
Receive thoughtful articles on software architecture, physical sciences, history, and systems. No algorithms, no sponsors, no noise.
আন্তঃসম্পর্কিত জ্ঞানচর্চা ও পাঠপরিক্রমা কগনিটিভ সায়েন্স ও কম্পিউটেশনাল ভাষাতত্ত্ব→পদার্থবিজ্ঞানের মহাবিকাশ
চিন্তার ধারাবাহিকতা: সংযুক্ত বিষয় ও সংকলন
কোয়ান্টাম বলবিদ্যা ও গতিবিদ্যার পর এবার পা রাখুন ১৩.৮ বিলিয়ন বছরের মহাজাগতিক রূপরেখায় — নক্ষত্রের জন্ম ও গ্যালাক্সির বিবর্তন থেকে মহাবিশ্বের ভবিষ্যৎ।
গ্যালিলিওর গতিবিদ্যা ও নিউটনের মহাকর্ষ থেকে শুরু করে ম্যাক্সওয়েল, আইনস্টাইন, কোয়ান্টাম বলবিদ্যা এবং স্থান-কালের একীভূত কোয়ান্টাম গ্র্যাভিটির মহাকাব্যিক সন্ধান।
প্রস্তাবিত প্রবেশদ্বার ও গুরুত্বপূর্ণ মাইলফলক পর্বসমূহ:
বিশ্বব্যাপী সকল পাঠক, গবেষক ও শিক্ষার্থীদের জন্য উন্মুক্ত। গুগল বা যেকোনো ব্যক্তিগত ইমেইল দিয়ে সুরক্ষিতভাবে সাইন ইন করে পাঠ্যক্রমের অগ্রগতি সিঙ্ক ও চূড়ান্ত পরীক্ষায় অংশ নিন।
অথবা যেকোনো ইমেইল দিয়ে প্রবেশ করুন
🎓
Enrolled Academic Curricula (33 Disciplines)
The Great Equations (MATH-101)20 Parts • Mathematical Physics & Epistemology
The Story of Physics (PHYS-101)20 Parts • Classical & Modern Theoretical Physics
The Universal Chronicle (COSM-101)20 Parts • Astrophysics & Big History Cosmology
The Evolutionary Odyssey (BIOL-101)20 Parts • Paleobiology, Genetics & Macroevolution
The Story of Consciousness (PHIL-101)20 Parts • Cognitive Neuroscience & Philosophy of Mind
The History of Computing and AI (COMP-101)20 Parts • Computer Architecture & Machine Intelligence
The History of Bengal (HIST-101)20 Parts • Regional Historiography & Geopolitical Economy
The Epic of Human Civilization (CIV-101)20 Parts • World History & Civilizational Anthropology
The Evolution of Money & Markets (ECON-101)20 Parts • Monetary History, Central Banking & Macroeconomics
The Story of Chemistry (CHEM-101)20 Parts • Molecular Sciences, Quantum Bonding & Nanotechnology
The Story of Genetics (GEN-101)20 Parts • Molecular Biology, Genomics & Synthetic Life
The History of Philosophy (PHIL-101)20 Parts • Epistemology, Classical Metaphysics & Continental Thought
Game Theory & Mechanism Design (GAME-101)20 Parts • Strategic Interaction, Mechanism Design & Algorithmic Economics