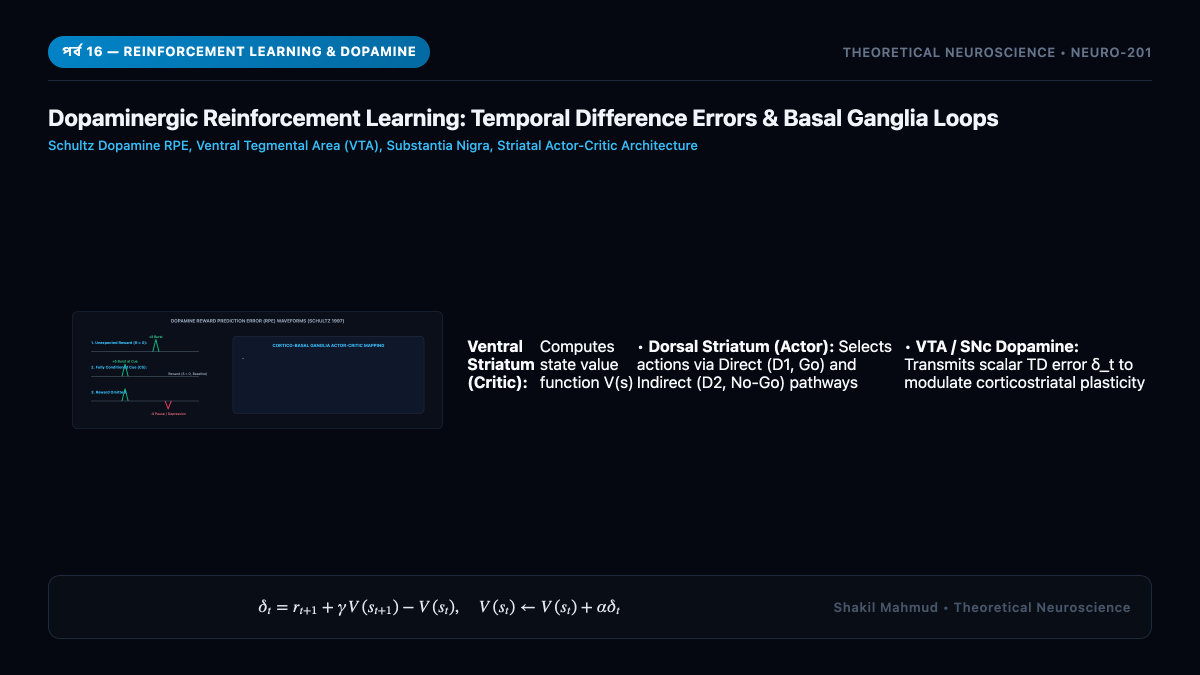
১৯৯০-এর দশকের শেষভাগে কম্পিউটার বিজ্ঞান এবং জৈব স্নায়ুবিজ্ঞানের মধ্যে অন্যতম শ্রেষ্ঠ মেলবন্ধনটি ঘটেছিল পুরস্কার ও সিদ্ধান্ত গ্রহণের গবেষণায়। একদিকে কম্পিউটার বিজ্ঞানী রিচার্ড সাটন ও অ্যান্ড্রু বার্টো কৃত্রিম বুদ্ধিমত্তার জন্য তৈরি করছিলেন টেম্পোরাল ডিফারেন্স (TD) লার্নিং, অন্যদিকে উলফ্রাম শুল্টজ বানরের মস্তিষ্কে ডোপামিন নিউরনের ফায়ারিং রেকর্ড করছিলেন। পিটার দায়ান ও রিড মন্টাগু যখন দুটি ফলাফল পাশাপাশি রাখলেন, তখন মানব ইতিহাসের এক পরম সত্য উন্মোচিত হলো: ডোপামিন কেবল কোনো আনন্দের রাসায়নিক নয়; এটি মূলত নিখুঁত গাণিতিক রিওয়ার্ড প্রেডিকশন এরর বা পুরস্কার পূর্বাভাসের ত্রুটি ($delta_t$) বহনকারী সংকেত।
১. টেম্পোরাল ডিফারেন্স (TD) অ্যালগরিদম
ভবিষ্যতের মোট সম্ভাব্য পুরস্কারের প্রত্যাশিত মান হলো ভ্যালু ফাংশন $V(s_t)$। সাটন ও বার্টোর $text{TD}(0)$ অ্যালগরিদম ভবিষ্যতের জন্য অপেক্ষা না করে পরপর দুটি সময়ের প্রত্যাশার পার্থক্যের ওপর ভিত্তি করে এরর নির্ণয় করে:
delta_t = r_{t+1} + gamma V(s_{t+1}) – V(s_t)
এই ত্রুটি বা এরর সংকেত দিয়ে ভ্যালু ফাংশন আপডেট করা হয়: $V(s_t) leftarrow V(s_t) + alpha delta_t$।
২. শুল্টজের ডোপামিন ট্রায়াড ও RPE তরঙ্গরূপ
১৯৯৭ সালে শুল্টজ, দায়ান ও মন্টাগু প্রমাণ করেন যে ভেন্ট্রাল টেগমেন্টাল এরিয়া (VTA)-এর ডোপামিন নিউরনগুলো নিখুঁতভাবে এই সমীকরণটি মেনে চলে:
- অপ্রত্যাশিত পুরস্কার ($r > 0, delta > 0$): হঠাৎ জুসের ড্রপ দিলে ডোপামিন নিউরনগুলো তীব্র ফেজিক বিস্ফোরণ ($৩০text{–}৪০text{ Hz}$) ঘটায়।
- পূর্বাভাসপ্রাপ্ত পুরস্কার ($delta = 0$): ঘণ্টার শব্দের পর পুরস্কার দিতে অভ্যস্ত করার পর দেখা যায়, ডোপামিন স্পাইকটি ঘণ্টার শব্দ আসার মুহূর্তে চলে গেছে। আসল পুরস্কার পাওয়ার সময় আর কোনো অতিরিক্ত স্পাইক হয় না ($delta = 0$)।
- পুরস্কার না পাওয়া ($delta < 0$): ঘণ্টার শব্দ বাজিয়ে প্রত্যাশিত মুহূর্তে পুরস্কার না দিলে ডোপামিন নিউরনগুলো সাময়িকভাবে পুরোপুরি স্তব্ধ বা নিশ্চুপ হয়ে যায়।
৩. ব্যাসাল গ্যাংলিয়া: জীবতাত্ত্বিক অ্যাক্টর-ক্রিটিক আর্কিটেকচার
মস্তিষ্কের ব্যাসাল গ্যাংলিয়া হুবহু এআই-এর অ্যাক্টর-ক্রিটিক কাঠামোর মতো কাজ করে:
- ক্রিটিক (ভেন্ট্রাল স্ট্রাইটাম): বর্তমান অবস্থার মান $V(s)$ গণনা করে এবং VTA-তে দমনমূলক সংকেত পাঠিয়ে প্রত্যাশিত পুরস্কারকে বাতিল করে এরর $delta_t$ বের করে।
- অ্যাক্টর (ডরসাল স্ট্রাইটাম): দুটি বিপরীতমুখী পথের মাধ্যমে কাজ বাছাই করে:
- ডিরেক্ট পথ (“Go”, D1 রিসেপ্টর): পজিটিভ ডোপামিন স্পাইক এই পথকে শক্তিশালী করে এবং সফল কাজকে অভ্যাসে পরিণত করে।
- ইনডিরেক্ট পথ (“No-Go”, D2 রিসেপ্টর): ডোপামিনের অনুপস্থিতি বা ড্রপ এই পথকে সক্রিয় করে ব্যর্থ বা ক্ষতিকর আচরণকে দমন করে।
৪. তিন-উপাদান সিন্যাপটিক প্লাস্টিসিটি (Three-Factor Learning)
চিরায়ত হেবিয়ান তত্ত্বে কেবল প্রিসিন্যাপটিক ও পোস্টসিন্যাপটিক নিউরনের যোগসূত্র থাকে। কিন্তু রিইনফোর্সমেন্ট লার্নিংয়ে প্রয়োজন একটি তৃতীয় বৈশ্বিক ফিডব্যাক উপাদান: ডোপামিন। প্রিসিন্যাপটিক ও পোস্টসিন্যাপটিক সক্রিয়তা একটি রাসায়নিক এলিজিবিলিটি ট্রেস $e_{ij}(t)$ তৈরি করে রাখে। এর কয়েক সেকেন্ডের মধ্যে যদি একটি ডোপামিন সংকেত এসে পৌঁছায়, তবেই সেই সিন্যাপস স্থায়ীভাবে শক্তিশালী হয়। এই তিন-উপাদান নিয়মই সময়ের ব্যবধান অতিক্রম করে মস্তিষ্ককে অভিজ্ঞতা থেকে শিখতে সাহায্য করে।




