কম্পিউটার বিজ্ঞানের সূচনালগ্ন থেকে প্রতিটি ভাষার বাক্যকে প্রসেস করা হতো ধাপে ধাপে: একটি অক্ষরের পর আরেকটি অক্ষর, একটি শব্দের পর আরেকটি শব্দ। কিন্তু ২০১৭ সালের জুনে গুগল ব্রেইনের আটজন বিজ্ঞানী মাত্র আট পৃষ্ঠার একটি পেপার প্রকাশ করলেন, যার শিরোনাম ছিল অসম্ভব সাহসী: “অ্যাটেনশন ইজ অল ইউ নিড (Attention Is All You Need)”। রিকারেন্ট নেটওয়ার্কের সমস্ত পুরোনো নিয়ম ছুড়ে ফেলে দিয়ে তাঁরা উদ্ভাবন করলেন ‘ট্রান্সফরমার’—যা আজকের চ্যাটজিপিটি থেকে শুরু করে পৃথিবীর সমস্ত আধুনিক বৃহৎ ভাষা মডেলের (LLM) মূল চালিকাশক্তি।
১. রিকারেন্ট নেটওয়ার্কের ধীরগতির সংকট
২০১৭ সালের আগে ভাষা অনুবাদের জন্য ব্যবহৃত হতো রিকারেন্ট নিউরাল নেটওয়ার্ক (RNN) এবং এলএসটিএম (LSTM)। এরা বাক্যের প্রথম শব্দ থেকে শুরু করে একে একে শেষের দিকে এগিয়ে যেত:
$$h_t = f(h_{t-1}, x_t)$$এর ফলে দুটি ভয়াবহ বাধার সৃষ্টি হতো:
- প্যারালাল প্রসেসিংয়ের অসম্ভবতা: পূর্ববর্তী শব্দের হিসাব শেষ না হওয়া পর্যন্ত পরবর্তী শব্দের হিসাব করা যেত না। হাজার হাজার কোরবিশিষ্ট শক্তিশালী আধুনিক জিপিইউ অলস বসে থাকত।
- বিস্মৃতি বা মেমোরি সংকট: বাক্য ১০০ শব্দের বেশি লম্বা হলে বাক্যের শুরুর তথ্যের সাথে শেষের সম্পর্কের যোগসূত্র ক্রমান্বয়ে মুছে যেত।
২. ‘অ্যাটেনশন ইজ অল ইউ নিড’ এবং সেলফ-অ্যাটেনশন
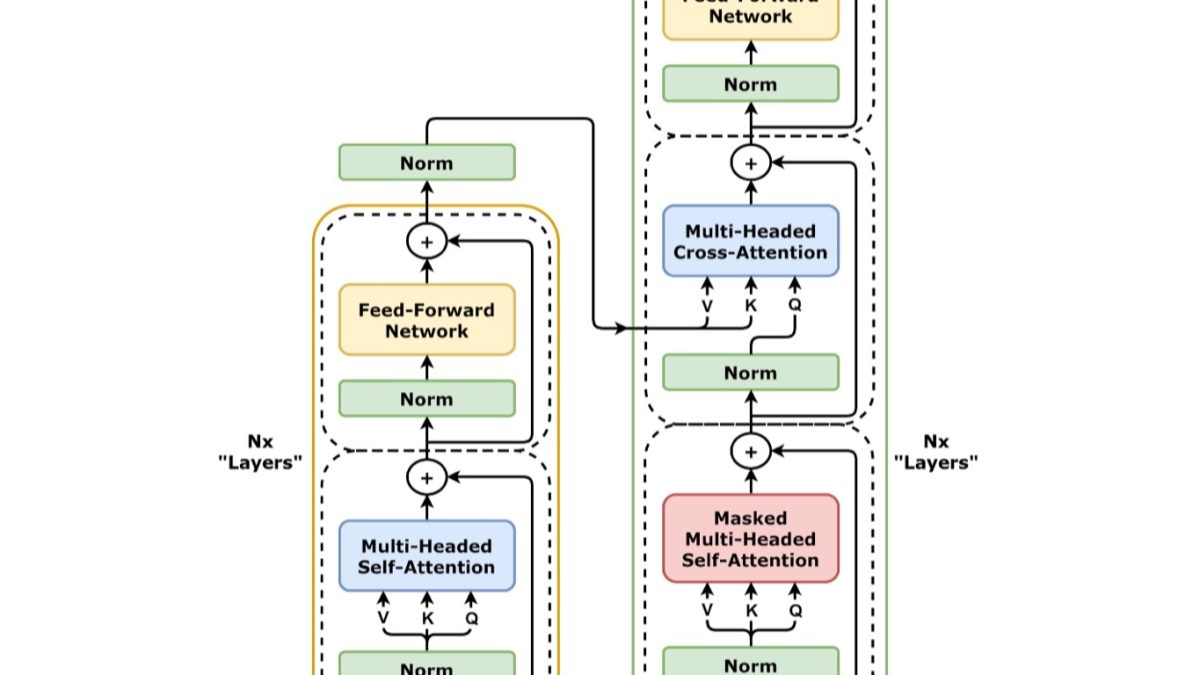
গুগল ব্রেইনের বিজ্ঞানী আশিস ভাসওয়ানি, নোয়াম শাযির, নিকি পারমার, জ্যাকব উশকোরিট প্রমুখ প্রস্তাব করলেন: ধাপে ধাপে এগোনোর কোনো প্রয়োজন নেই। পুরো বাক্যের সমস্ত শব্দকে একসাথে মেমোরিতে নাও এবং প্রতিটি শব্দকে একই সাথে বাক্যের অন্য সমস্ত শব্দের সাথে সম্পর্কযুক্ত করো—যার নাম সেলফ-অ্যাটেনশন (Self-Attention)।
স্কেলড ডট-প্রোডাক্ট অ্যাটেনশনের গণিত
ট্রান্সফরমার প্রতিটি শব্দকে তিনটি ভেক্টরে রূপান্তর করে: কোয়েরি (Query – $Q$), কি (Key – $K$) এবং ভ্যালু (Value – $V$):
$$\text{Attention}(Q, K, V) = \text{softmax}\left( \frac{Q K^T}{\sqrt{d_k}} \right) V$$একটি ম্যাট্রিক্স গুণনের মাধ্যমে বাক্যের প্রতিটি শব্দের সাথে অন্য প্রতিটি শব্দের সম্পর্কের গভীরতা নিমিষেই নির্ণয় করা যায়। দূরত্বের কোনো বাধা নেই—শব্দ দুটি বাক্যের শুরুতে বা ১,০০০ শব্দ দূরে যেখানেই থাকুক না কেন, মাত্র $O(১)$ ধাপে তারা একে অপরের দিকে “মনোযোগ” দিতে পারে!
৩. প্রাক-প্রশিক্ষণ বিপ্লব: বিইআরটি (BERT) এবং জিপিটি (GPT)
ট্রান্সফরমারের বিশাল সমান্তরাল ক্ষমতার ওপর ভিত্তি করে ২০১৮ সালে ভাষা প্রক্রিয়াকরণ দুটি মহাকাব্যিক ধারায় বিভক্ত হয়ে যায়:
- বিইআরটি (BERT, গুগল, ২০১৮): ট্রান্সফরমারের এনকোডার অংশ ব্যবহার করে বাক্যের শূন্যস্থান পূরণের মাধ্যমে ভাষা শিখত:
আমি [MASK] খাই। রাতারাতি ভাষা বোঝার সমস্ত বিশ্ব রেকর্ড ভেঙে ফেলে বিইআরটি। - জিপিটি (GPT, ওপেনএআই, ২০১৮–২০২০): ট্রান্সফরমারের ডিকোডার অংশ ব্যবহার করে পূর্ববর্তী শব্দের ওপর ভিত্তি করে পরবর্তী শব্দ কী হবে তা অনুমান করা: $P(w_t \mid w_1, \dots, w_{t-1})$। ওপেনএআই প্রমাণ করল যে কোটি কোটি ইন্টারনেটের লেখার ওপর পরবর্তী শব্দ অনুমানের সাধারণ কাজটি করতে গিয়েই মডেলের ভেতর যুক্তিবোধ, অনুবাদ এবং কোডিংয়ের অতিমানবীয় ক্ষমতা নিজ থেকেই ফুটে ওঠে!
৪. নিউরাল স্কেলিং ল (Neural Scaling Laws): এআইয়ের ভৌত সূত্র
২০২০ সালে ওপেনএআইয়ের তাত্ত্বিক পদার্থবিদ জ্যারেড কাপলান এক অবিস্মরণীয় বৈজ্ঞানিক সত্য আবিষ্কার করলেন। ভাষা মডেলের কার্যক্ষমতা কোনো সৌভাগ্যের ওপর নির্ভর করে না; এটি পদার্থবিজ্ঞানের মতো সুনির্দিষ্ট পাওয়ার-ল (Power-law) মেনে চলে:
$$L(C) \approx \left(\frac{C_c}{C}\right)^{\alpha_C}$$কম্পিউটিং শক্তি ($C$), ডেটার পরিমাণ ($D$) এবং মডেলের প্যারামিটার ($N$) গুণোত্তর হারে বৃদ্ধি করলে মডেলের ভুল বা লস ($L$) অত্যন্ত সুসংগতভাবে কমতে থাকে।
২০২২ সালে ডিপমাইন্ড প্রকাশ করে তাদের বিখ্যাত চিনচিলা (Chinchilla) স্কেলিং সূত্র: কম্পিউটিং শক্তির সর্বোত্তম ব্যবহারের জন্য প্যারামিটার এবং ডেটাকে সমান অনুপাতে দ্বিগুণ করতে হবে। ট্রান্সফরমার কেবল সাধারণ সফটওয়্যার ছিল না; এটি ছিল এমন এক গাণিতিক ইঞ্জিন, যাতে কম্পিউটিং শক্তি ঢাললে তা সরাসরি বুদ্ধিমত্তায় রূপান্তরিত হয়।
প্রধান একাডেমিক তথ্যসূত্র
- Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS, 30, 5998–6008.
- Devlin, J., et al. (2018). BERT. NAACL-HLT, 4171–4186.
- Radford, A., et al. (2019). Language models are unsupervised multitask learners. OpenAI.
- Kaplan, J., et al. (2020). Scaling laws for neural language models. arXiv:2001.08361.
- Hoffmann, J., et al. (2022). Training compute-optimal large language models. NeurIPS, 35.