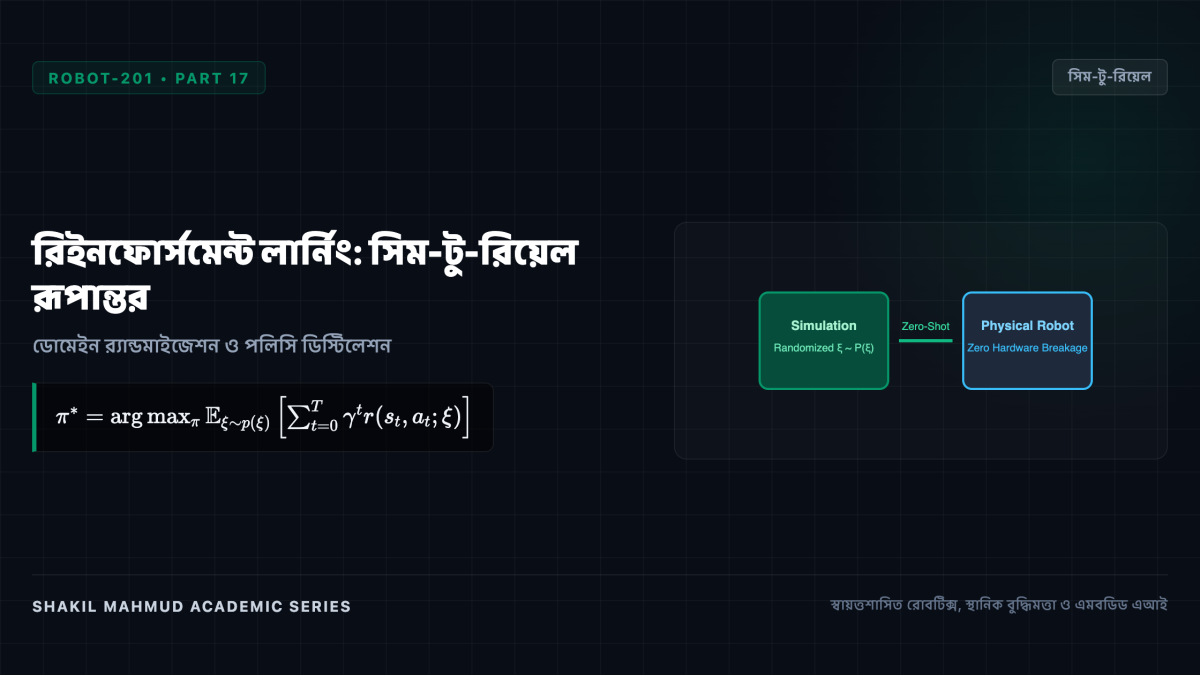
গতানুগতিক গাণিতিক সমীকরণ দিয়ে পাথুরে মাটিতে দৌড়ানো, শূন্যে লাফিয়ে বল ধরা কিংবা মানুষের হাতের মতো ২৪টি জয়েন্ট ঘুরিয়ে রুবিকস কিউব মেলানোর মতো জটিল কাজ নিখুঁতভাবে মডেল করা প্রায় অসম্ভব। এই ধরনের জটিল কাজে রোবটকে নিজের চেষ্টায় ভুল থেকে শিখতে হয় ডিপ রিইনফোর্সমেন্ট লার্নিং (RL)-এর মাধ্যমে। বাস্তব রোবট যেন ভেঙে না যায়, সেজন্য কম্পিউটারের জিপিইউ সিমুলেশনে কোটি কোটি রোবটকে একসাথে প্রশিক্ষণ দিয়ে ডোমেইন র্যান্ডমাইজেশন ও পলিসি ডিস্টিলেশনের মাধ্যমে বাস্তব জগতে সফলভাবে প্রয়োগ করা হয়।
১. রোবট নিয়ন্ত্রণের মার্কভ ডিসিশন প্রসেস (MDP)
রোবট রিইনফোর্সমেন্ট লার্নিং পরিচালিত হয় ধারাবাহিক পুরস্কারের ওপর ভিত্তি করে:
- স্টেট ((mathcal{S})): রোবটের জয়েন্টের বর্তমান কোণ, গতিবেগ ও শরীরের ভারসাম্য।
- অ্যাকশন ((mathcal{A})): মোটরের জন্য কাঙ্ক্ষিত টার্গেট কোণ।
- রিওয়ার্ড ফাংশন ((mathcal{R})): রোবট সামনে এগোলে পুরস্কার পায়, আর পা পিছলালে বা অতিরিক্ত বিদ্যুৎ খরচ করলে শাস্তি (পেনাল্টি) পায়।
আধুনিক রোবটিক্সে Proximal Policy Optimization (PPO) অ্যালগরিদম ব্যবহার করে পলিসি নিউরাল নেটওয়ার্ককে এমনভাবে আপডেট করা হয় যাতে প্রতি পদক্ষেপে রোবটের দক্ষতা ধারাবাহিকভাবে বৃদ্ধি পায়।
২. রিয়েলিটি গ্যাপ ও সমান্তরাল জিপিইউ সিমুলেশন
বাস্তব রোবটকে দৌড়ানো শেখাতে কয়েক বছর সময় লাগবে এবং বারবার পড়ে গিয়ে শত কোটি টাকার হার্ডওয়্যার ধ্বংস হবে। এনভিডিয়ার আইজ্যাক জিম (Isaac Gym) বা মুজোকো ব্যবহার করে জিপিইউ-এর ভেতর একসাথে ১০,০০০ থেকে ৫০,০০০ রোবট সিমুলেট করা হয়। মাত্র ২০ মিনিটে রোবটগুলো ১০ বছরের চলার অভিজ্ঞতা অর্জন করে ফেলে!
তবে সিমুলেশনের জগত বাস্তব পৃথিবীর চেয়ে নিখুঁত হওয়ায় তৈরি হয় রিয়েলিটি গ্যাপ (Reality Gap)। সিমুলেশনে সফল রোবট বাস্তব মেঝেতে পা রাখলেই পড়ে যায়।
৩. ডোমেইন র্যান্ডমাইজেশন (Domain Randomization)
এই সমস্যা দূর করতে ডোমেইন র্যান্ডমাইজেশনে হাজার হাজার সিমুলেশনের প্রতিটি রোবটের ভৌত পরিবেশ ইচ্ছাকৃতভাবে এলোমেলো করে দেওয়া হয়:
- রোবটের বিভিন্ন অংশের ওজন (pm ২০%) এলোমেলোভাবে বাড়ানো বা কমানো হয়।
- মেঝের ঘর্ষণ গুণাঙ্ক কখনো কাঁচের মতো পিচ্ছিল, কখনো বালির মতো অমসৃণ রাখা হয়।
- মোটরের প্রতিক্রিয়া এবং সেন্সরের তথ্যে ইচ্ছাকৃতভাবে ৫ থেকে ৪০ মিলিসেকেন্ড পর্যন্ত বিলম্ব (Latency) ও নয়েজ যোগ করা হয়।
লাখ লাখ বৈচিত্র্যময় পরিবেশে টিকে থাকার পর বাস্তব পৃথিবী রোবটের কাছে আরেকটি সাধারণ পরিচিত নমুনা বলে মনে হয়। ফলে কোনো বাস্তব ট্রায়াল ছাড়াই রোবটটি জিরো-শট সিম-টু-রিয়েল (Zero-Shot Sim-to-Real) সফলতায় বাস্তব মেঝেতে নিখুঁতভাবে হাঁটতে পারে।
৪. টিচার-স্টুডেন্ট পলিসি ডিস্টিলেশন
সিমুলেশনে একটি “টিচার মডেল” প্রশিক্ষণ দেওয়া হয় যা মেঝের ঘর্ষণ ও উচ্চতা সম্পর্কে শতভাগ নিখুঁত তথ্য জানে। এরপর একটি সাধারণ “স্টুডেন্ট মডেলকে” কেবল নিজের শরীরের জয়েন্টের কম্পন ও অনুভূতির ওপর ভিত্তি করে টিচারের মতো নির্ভুল সিদ্ধান্ত নিতে সুপারভাইজড লার্নিংয়ের মাধ্যমে ডিস্টিলেশন (Distillation) করা হয়। ফলে কোনো বাহ্যিক ক্যামেরা ছাড়াই কেবল শারীরিক স্পর্শের অনুভূতি দিয়ে রোবট পাহাড়ি পথ অতিক্রম করতে পারে।




