২০২০ থেকে ২০২২ সালের মধ্যে কৃত্রিম বুদ্ধিমত্তা একটি পরীক্ষামূলক কারিগরি বিদ্যা থেকে গণনামূলক পদার্থবিদ্যার (computational physics) মতো সুনির্দিষ্ট নিয়মে পরিচালিত এক বিজ্ঞানে রূপান্তরিত হয়। নিউরাল স্কেলিং ল (Scaling Laws)-এর আবিষ্কার গবেষকদের দেখিয়ে দেয় যে মডেলের পারফরম্যান্স ও যৌক্তিক চিন্তা কোনো আকস্মিক যোগাযোগ নয়, বরং কম্পিউট শক্তি, প্যারামিটার সংখ্যা এবং ডেটাসেট আকারের একটি সুনির্দিষ্ট পাওয়ার-ল (Power-law) গাণিতিক ফাংশন।
১. কাপলান স্কেলিং ল (২০২০) ও পাওয়ার-ল ফ্রন্টিয়ার
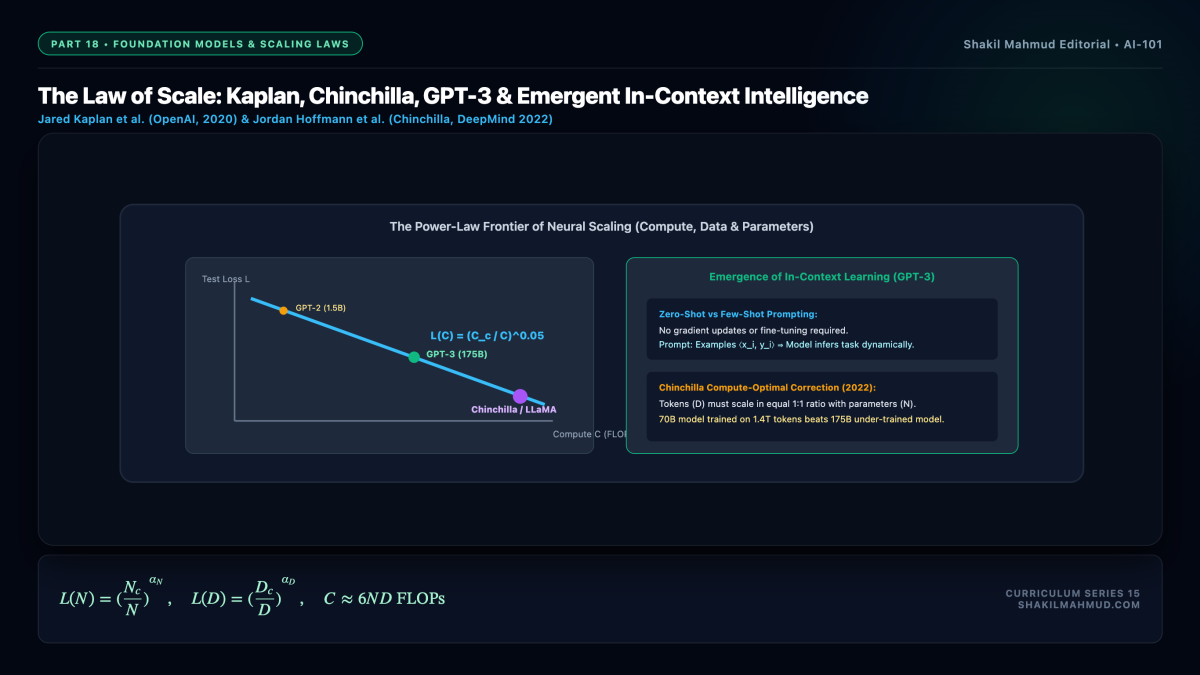
২০২০ সালে ওপেনএআই-এর গবেষক জ্যারেড কাপলান ও তাঁর সহকর্মীরা প্রকাশ করেন “Scaling Laws for Neural Language Models”। তাঁরা দেখান যে অটোরিগ্রেসিভ ল্যাঙ্গুয়েজ মডেলের ক্রস-এনট্রপি টেস্ট লস ($L$) কম্পিউট ($C$), ডেটা ভলিউম ($D$) এবং প্যারামিটার সংখ্যা ($N$)-এর সাথে সুনির্দিষ্ট সূচকে হ্রাস পায়:
$$L(N) = left(frac{N_c}{N}right)^{alpha_N}, quad L(D) = left(frac{D_c}{D}right)^{alpha_D}, quad L(C) = left(frac{C_c}{C}right)^{alpha_C}$$
সবচেয়ে গুরুত্বপূর্ণ আবিষ্কার ছিল এই যে, এই স্কেলিং সম্পর্ক কয়েক ডজন ক্রম ধরে কোনো স্থবিরতা ছাড়াই অব্যাহত থাকে। কাপলানের প্রাথমিক সূত্রে বলা হয়েছিল নির্দিষ্ট কম্পিউট বাজেট $C approx 6ND$-তে মডেলের প্যারামিটার বৃদ্ধি করা ($N propto C^{0.73}$) ডেটা বৃদ্ধির ($D propto C^{0.27}$) চেয়ে বেশি কার্যকর। এই ধারণার উপর ভিত্তি করেই তৈরি হয়েছিল ১৭৫ বিলিয়ন প্যারামিটারের বিশালাকার জিপিটি-৩ (GPT-3)।
২. চিনচিলা সংশোধন: সর্বোত্তম কম্পিউট বণ্টন
২০২২ সালের মার্চ মাসে ডিপমাইন্ডের জর্ডান হফম্যান ও তাঁর দল প্রকাশ করেন “Training Compute-Optimal Large Language Models” (যার মাধ্যমে ৭০ বিলিয়ন প্যারামিটারের চিনচিলা মডেল তৈরি হয়)। ডিপমাইন্ড প্রমাণ করে যে কাপলানের পরীক্ষায় লার্নিং রেট শিডিউলিংয়ের ত্রুটির কারণে ডেটাসেটের গুরুত্বকে অবমূল্যায়ন করা হয়েছিল।
প্যারামিটার ও টোকেনের সম্মিলিত লস সমীকরণ বিশ্লেষণ করে:
$$L(N, D) = E + frac{A}{N^alpha} + frac{B}{D^beta}$$
ডিপমাইন্ড দেখায় যে $alpha approx 0.34$ এবং $beta approx 0.28$, যার অর্থ প্যারামিটার ও ডেটা টোকেন সমানুপাতিক হারে (১:১ অনুপাতে) বৃদ্ধি করা উচিত:
$$N propto C^{0.50}, quad D propto C^{0.50}$$
অর্থাৎ মডেলের প্রতিটি প্যারামিটারের জন্য প্রায় ২০টি টোকেন ডেটা প্রয়োজন ($D approx 20N$)। দেখা গেল জিপিটি-৩ (১৭৫ বিলিয়ন প্যারামিটার, কিন্তু মাত্র ৩০০ বিলিয়ন টোকেন) মারাত্মকভাবে অপূর্ণ-প্রশিক্ষিত ছিল। চিনচিলা মাত্র ৭০ বিলিয়ন প্যারামিটার নিয়ে ১.৪ ট্রিলিয়ন টোকেনে প্রশিক্ষিত হয়ে জিপিটি-৩-কে বিপুল ব্যবধানে পরাজিত করে।
৩. ইন-কনটেক্সট লার্নিং-এর বিস্ময়
স্কেলিংয়ের সবচেয়ে বৈপ্লবিক ফল ছিল ইন-কনটেক্সট লার্নিং। জিপিটি-৩-এর পূর্বে যেকোনো নতুন কাজের জন্য মডেলের ওজন আপডেট করে ফাইন-টিউনিং করতে হতো।
কিন্তু ১৭৫ বিলিয়ন প্যারামিটারে পৌঁছানোর পর জিপিটি-৩ কোনো ব্যাকপ্রোপাগেশন বা প্যারামিটার পরিবর্তন ছাড়াই কেবল প্রম্পটের ভেতরে কয়েকটি উদাহরণ দেখে নতুন কাজ সম্পাদন করতে সক্ষম হয়:
$$theta^* = theta, quad hat{y} = argmax_y P_theta(y mid x_{text{prompt}}, x_{text{context}})$$
মডেলটি তার ইন্টারনাল সেলফ-অ্যাটেনশন অ্যাক্টিভেশনের মাধ্যমে একটি ভার্চুয়াল লার্নিং অ্যালগরিদম কার্যকর করে। এখান থেকেই জন্ম নেয় ফাউন্ডেশন মডেল (Foundation Model) ধারণা—ইন্টারনেট স্কেলের বিপুল ডেটায় স্ব-তত্ত্বাবধানে প্রশিক্ষিত একক মডেল, যা অসংখ্য বিচিত্র কাজের সর্বজনীন ভিত্তি হিসেবে কাজ করে।
৪. ইমার্জেন্ট ক্যাপাবিলিটি ও কৃত্রিম বোধশক্তি
মডেল যখন নির্দিষ্ট কম্পিউট সীমা অতিক্রম করে ($>10^{22}$ FLOPs), তখন হঠাৎ করেই কিছু অপ্রত্যাশিত সক্ষমতার জন্ম হয়: জটিল বহু-ধাপ বিশিষ্ট গাণিতিক যুক্তি, কোড জেনারেশন, এবং মনস্তাত্ত্বিক যুক্তি। কম্পিউট এবং ডেটার সুশৃঙ্খল স্কেলিং কেবল বাক্য সম্পূর্ণ করার যান্ত্রিক কৌশলকে এক বিস্ময়কর অনুধাবন ক্ষমতায় রূপান্তর করে।