২০১৭ সালের জুন মাসে, গুগল ব্রেন ও গুগল রিসার্চের একদল গবেষক আট পৃষ্ঠার একটি গবেষণাপত্র প্রকাশ করেন যার শিরোনাম ছিল অবিশ্বাস্যরকম সাহসী—“Attention Is All You Need”। পরবর্তী ছত্রিশ মাসের মধ্যে এর মূল উদ্ভাবন—ট্রান্সফরমার (Transformer)—প্রাকৃতিক ভাষা প্রক্রিয়াকরণ (NLP), কম্পিউটার ভিশন, স্পিচ সংশ্লেষণ এবং প্রোটিন ফোল্ডিংয়ে তিন দশকের প্রচলিত রিকারেন্ট এবং কনভোল্যুশনাল নেটওয়ার্কের আধিপত্য সম্পূর্ণরূপে গুঁড়িয়ে দেয়। রিকারেন্স বাদ দিয়ে বিশুদ্ধ ভেক্টরাইজড সেলফ-অ্যাটেনশন গ্রহণের মাধ্যমে ট্রান্সফরমার গভীর অনুক্রমিক শিক্ষার সবচেয়ে বড় প্রকৌশলগত প্রতিবন্ধকতা দূর করে।
১. রিকারেন্সের প্রতিবন্ধকতা: $O(n)$ অনুক্রমিক গণনার সীমাবদ্ধতা
১৯৮০-এর দশকের মাঝামাঝি থেকে ২০১৭ পর্যন্ত অনুক্রমিক ডেটা বিশ্লেষণে রাজত্ব করছিল রিকারেন্ট নিউরাল নেটওয়ার্ক (RNN) এবং এর আধুনিক রূপ এলএসটিএম (LSTM) ও জিআরইউ (GRU)। তবে এলএসটিএম-এর একটি সহজাত সীমাবদ্ধতা ছিল: এটি প্রতিটি শব্দের লুকায়িত অবস্থা ($h_t$) নির্ণয় করতে পূর্ববর্তী শব্দের অবস্থা ($h_{t-1}$)-এর ওপর নির্ভরশীল ছিল:
$$h_t = sigma(W x_t + U h_{t-1} + b)$$
এই অনুক্রমিক নির্ভরতার কারণে একটি $n$ দৈর্ঘ্যের বাক্যের জন্য $O(n)$ সংখ্যক ধারাবাহিক ধাপের প্রয়োজন হতো, যা আধুনিক জিপিইউ (GPU) বা টিপিইউ (TPU)-তে সমান্তরালভাবে গণনার সুযোগ নষ্ট করত। শত শত টোকেনের দূরত্বে পৌঁছাতে গিয়ে ভ্যানিশিং গ্রেডিয়েন্টের শিকার হয়ে মডেল অতীতের তথ্য ভুলে যেত।
২. স্কেলড ডট-প্রোডাক্ট ও মাল্টি-হেড সেলফ-অ্যাটেনশন
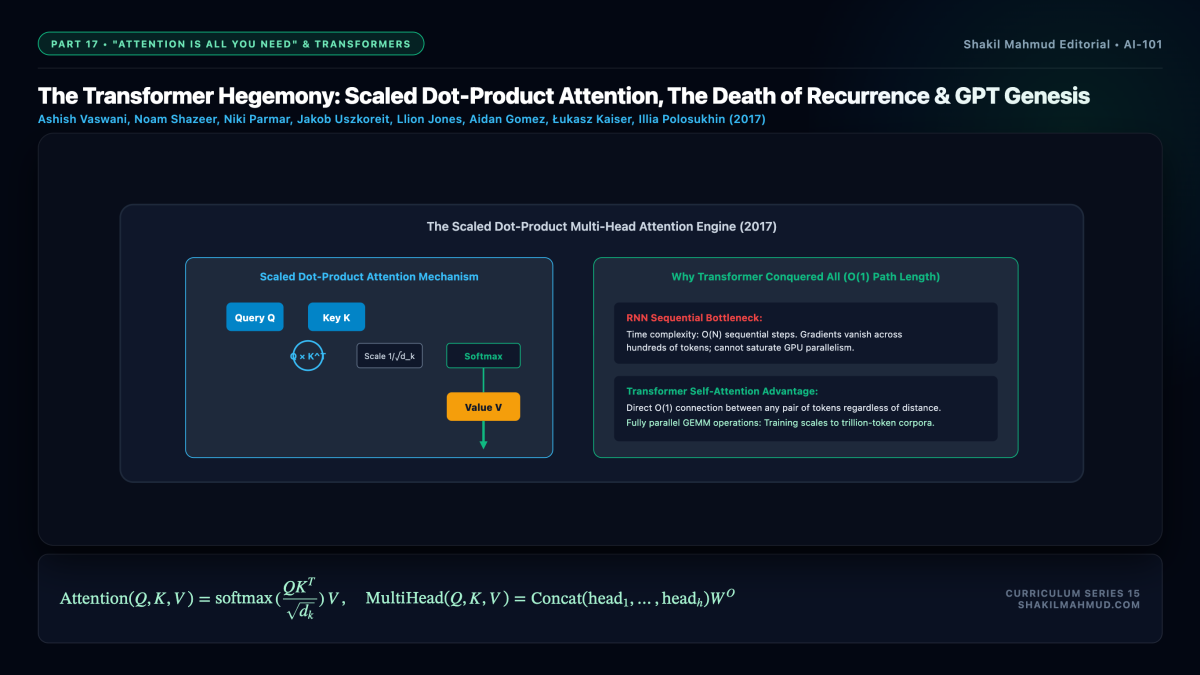
ট্রান্সফরমার অনুক্রমিক পুনরাবৃত্তির পরিবর্তে নিয়ে আসে সেলফ-অ্যাটেনশন (Self-Attention), যেখানে একটি বাক্যের প্রতিটি টোকেন একই সাথে অন্য সব টোকেনের সাথে সরাসরি মিথস্ক্রিয়া করতে পারে। কুয়েরি ($Q$), কি ($K$) এবং ভ্যালু ($V$) ম্যাট্রিক্সের মাধ্যমে অ্যাটেনশন গণনা করা হয়:
$$text{Attention}(Q, K, V) = text{softmax}left(frac{QK^T}{sqrt{d_k}}right)V$$
এখানে $frac{1}{sqrt{d_k}}$ স্কেলিং ফ্যাক্টরটি গাণিতিকভাবে অপরিহার্য: ডাইমেনশন $d_k$ বড় হলে ডট প্রোডাক্টের মান অত্যন্ত বৃদ্ধি পায়, যার ফলে সফটম্যাক্স ফাংশনের গ্রেডিয়েন্ট শূন্যের কাছাকাছি চলে যায়। এই ভাগটি ভ্যারিয়েন্সকে স্থিতিশীল রাখে।
কেবল একক অ্যাটেনশনের বদলে মাল্টি-হেড অ্যাটেনশন (Multi-Head Attention) $h$ সংখ্যক স্বাধীন লিনিয়ার প্রজেকশনের মাধ্যমে সমান্তরালভাবে একাধিক দিক থেকে টোকেনগুলোর সম্পর্ক নির্ণয় করে:
$$text{MultiHead}(Q, K, V) = text{Concat}(text{head}_1, dots, text{head}_h)W^O$$
এর ফলে মডেলটি একই বাক্যে ব্যাকরণগত সম্পর্ক, সর্বনামের সংযোগ, এবং গভীর অর্থগত গঠন একই সাথে অনুধাবন করতে পারে।
৩. ইনডাক্টিভ বায়াসের বিলুপ্তি ও অসীম স্কেলেবিলিটি
কনভোল্যুশনাল নেটওয়ার্কে থাকে স্থানিক সাদৃশ্যের অনুমান (spatial inductive bias) এবং আরএনএন-এ থাকে কালিক ধারাবাহিকতার অনুমান। কিন্তু ট্রান্সফরমারে কোনো পূর্বনির্ধারিত কঠোর অনুমান থাকে না—এটি টোকেনগুলোকে একটি সমান্তরাল সেট হিসেবে দেখে। ফলে শব্দের ক্রম বোঝাতে আলাদা পজিশনাল এনকোডিং (Positional Encoding) যোগ করা হয়:
$$PE_{(pos, 2i)} = sinleft(frac{pos}{10000^{2i/d_{text{model}}}}right), quad PE_{(pos, 2i+1)} = cosleft(frac{pos}{10000^{2i/d_{text{model}}}}right)$$
প্রথমদিকে এই কাঠামোগত অনুমানের অভাবকে দুর্বলতা মনে হলেও, বিপুল ডেটা এবং গণনাক্ষমতার সংযোগে ট্রান্সফরমার অবিশ্বাস্য গতিতে শিখতে সক্ষম হয়। এর $O(n^2)$ মুক্ত যোগাযোগ ম্যাট্রিক্স যেকোনো দুই টোকেনের মধ্যে তাৎক্ষণিক সম্পর্ক স্থাপন করে।
৪. বার্ট ও জিপিটি থেকে সর্বজনীন ফাউন্ডেশন মডেল
পরবর্তী বছরগুলোতে ট্রান্সফরমার মূলত তিনটি ধারায় বিকশিত হয়:
- এনকোডার-অনলি (BERT, RoBERTa): মাস্কড ল্যাঙ্গুয়েজ মডেলিংয়ের মাধ্যমে বাক্যের উভয় দিক থেকে অর্থ বের করতে পারদর্শী, যা ক্লাসিফিকেশন ও সার্চের ভিত্তি গড়ে তোলে।
- এনকোডার-ডিকোডার (T5, BART): মূল ট্রান্সফরমারের মতো অনুবাদের মতো জটিল সিকোয়েন্স-টু-সিকোয়েন্স রূপান্তরের জন্য ব্যবহৃত হয়।
- ডিকোডার-অনলি (GPT সিরিজ): কজাল মাস্কিংয়ের মাধ্যমে পরবর্তী শব্দ অনুমানের কৌশল গ্রহণ করে, যা আধুনিক জেনারেটিভ এআই বিপ্লবের চালিকাশক্তি হয়ে ওঠে।
২০২০ সালের মধ্যে ভিশন ট্রান্সফরমার (ViT) ইমেজ প্রসেসিংয়ে, আলফাফোল্ড ২ আণবিক জীববিজ্ঞানে এবং হুইস্পার ভয়েস রিকগনিশনে ট্রান্সফরমার সফলভাবে প্রয়োগ করে প্রমাণ করে যে এটি সমকালীন কৃত্রিম বুদ্ধিমত্তার সার্বজনীন স্থাপত্যিক ভিত্তি।