১৯৯০-এর দশকের মাঝামাঝি সময়ে কৃত্রিম বুদ্ধিমত্তা তার পুরোনো দার্শনিক প্রতিশ্রুতি থেকে বেরিয়ে আসে। একাধিক শীতকালের তিক্ত অভিজ্ঞতা গবেষকদের শিখিয়েছিল যে ভঙ্গুর রুলবেস বা নিউরাল নেটওয়ার্কের স্থানীয় মিনিমার গোলকধাঁধায় আটকে থাকা অর্থহীন। এর ফলে পুরো কম্পিউটার বিজ্ঞান জগতে ঘটে গেল এক যুগান্তকারী পরিবর্তন, যা পরিসংখ্যানিক রূপান্তর (The Statistical Turn) নামে পরিচিত। রুশ গণিতবিদ ভ্লাদিমির ভ্যাপনিকের সাপোর্ট ভেক্টর মেশিন (SVM) রাতারাতি আধুনিক মেশিন লার্নিংয়ের প্রধান চালিকাশক্তিতে পরিণত হলো।
১. ভ্যাপনিক-চেরভোনেনকিস (VC) তত্ত্ব ও সাধারণীকরণের বাউন্ড
সোভিয়েত ইউনিয়নে ভ্লাদিমির ভ্যাপনিক এবং আলেক্সি চেরভোনেনকিসের দীর্ঘ গবেষণায় গড়ে ওঠা স্ট্যাটিস্টিক্যাল লার্নিং থিওরি নিউরাল নেটওয়ার্কের সবচেয়ে বড় দুর্বলতা দূর করল। তারা দেখালেন—মডেলের প্যারামিটার সংখ্যা বেশি হলেই মডেল ভালো হয় না; অতিরিক্ত জটিল মডেল কেবল মুখস্থ করতে পারে (Overfitting)।
ভ্যাপনিক প্রমাণ করলেন যে অদেখা নতুন ডেটায় ভুলের হার ($R$) নির্ভর করে মূলত দুটি বিষয়ের ওপর: প্রশিক্ষণের ভুল এবং মডেলের ভিসি ডাইমেনশন ($h_{ ext{VC}}$) দ্বারা নির্ধারিত জটিলতা:
$$R(h) le R_{ ext{emp}}(h) + sqrt{rac{h_{ ext{VC}} left( log(2N / h_{ ext{VC}}) + 1
ight) – log(eta / 4)}{N}}$$
এর অর্থ হলো, সবচেয়ে ভালো মডেল সেটিই যা সবচেয়ে চওড়া ‘মার্জিন’ বজায় রেখে ডেটাকে আলাদা করতে পারে।
২. সাপোর্ট ভেক্টর মেশিন: উত্তল অপ্টিমাইজেশনের নিশ্চয়তা
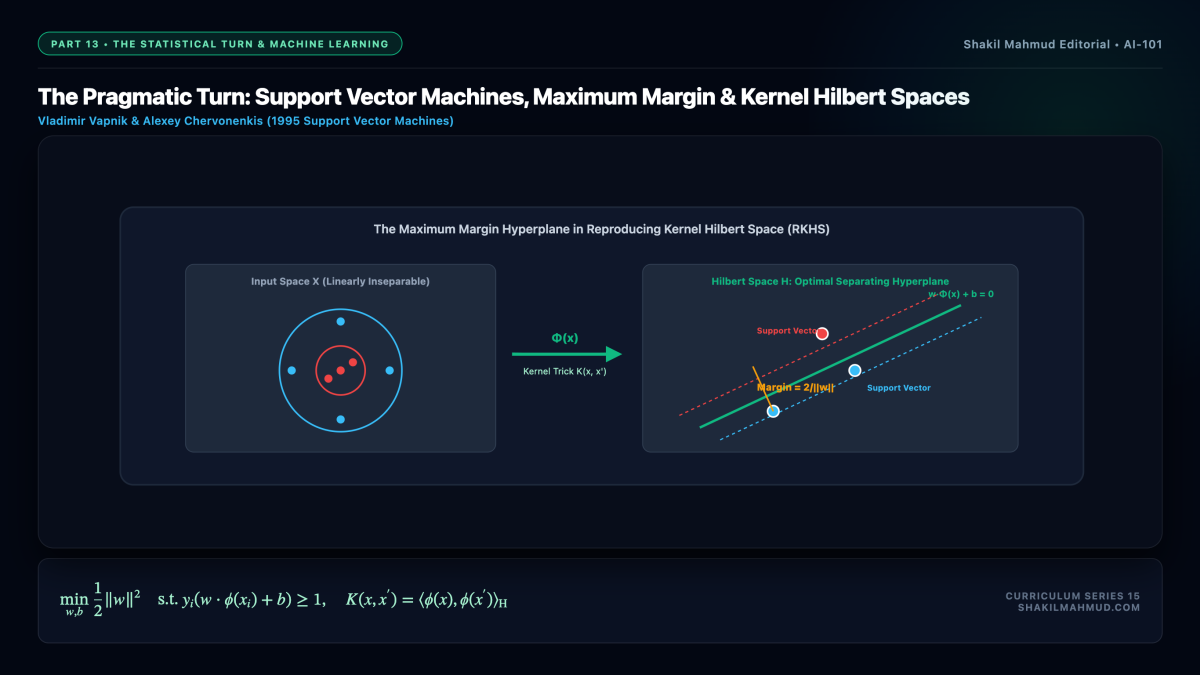
১৯৯৫ সালে ভ্যাপনিক ও কোরিনা কোর্টেস উন্মোচন করেন সাপোর্ট ভেক্টর মেশিন (SVM)। এর মূল লক্ষ্য হলো দুটি শ্রেণির ডেটার মাঝখান দিয়ে এমন একটি বিভাজন রেখা বা হাইপারপ্লেন ($w cdot x + b = 0$) তৈরি করা, যার দুই পাশের ফাঁকা স্থান বা মার্জিন ($rac{2}{|w|}$) হবে সর্বোচ্চ:
$$min_{w, b} rac{1}{2} |w|^2 quad ext{যেখানে } y_i (w cdot x_i + b) ge 1$$
ল্যাগ্রাঞ্জিয়ান ডুয়াল ফর্মুলেশনের মাধ্যমে এটি পরিণত হয় একটি কনভেক্স কোয়াড্রাটিক প্রোগ্রামিং সমস্যায়। নিউরাল নেটওয়ার্কের মতো এতে কোনো লোকাল মিনিমা বা আঁকাবাঁকা পথ থাকে না; এতে কেবল একটিই অনন্য বৈশ্বিক সমাধান (Global Optimum) বিদ্যমান, যা নির্ভুলভাবে হিসাব করা সম্ভব! সবচেয়ে মজার ব্যাপার হলো, পুরো মডেলটি নির্ভর করে কেবল মার্জিনের প্রান্তে থাকা কয়েকটি বিন্দুর ওপর—যাদের নাম সাপোর্ট ভেক্টর (Support Vectors)।
৩. কার্নেল ট্রিক: সসীম খরচে অসীম মাত্রা
যদি ডেটা সরলরেখা দিয়ে আলাদা করা না যায়? ১৯৯২ সালে আবিষ্কৃত হলো গণিতের সবচেয়ে জাদুকরী কৌশল: কার্নেল ট্রিক (The Kernel Trick)।
নন-লিনিয়ার ডেটাকে একটি উচ্চমাত্রিক (এমনকি অসীম মাত্রিক) হিলবার্ট স্পেসে প্রক্ষেপণ ($phi(x)$) করলে বাঁকানো ডেটাও সোজা সমতলে আলাদা হয়ে যায়। আর ডুয়াল সমীকরণের কল্যাণে উচ্চমাত্রার স্থানাঙ্ক কখনো সরাসরি হিসাব করার প্রয়োজনই হয় না! কেবল দুটি বিন্দুর ডট প্রোডাক্টকে একটি কার্নেল ফাংশন দিয়ে প্রতিস্থাপন করলেই চলে:
- পলিলিনিয়ার কার্নেল: $K(x, x’) = (x cdot x’ + c)^d$
- আরবিএফ / গাউসিয়ান কার্নেল: $K(x, x’) = expleft( -gamma |x – x’|^2
ight)$
মার্সারের উপপাদ্যের সাহায্যে সাধারণ একটি ডেস্কটপ পিসিতে কয়েক সেকেন্ডে অসীম মাত্রার সমতলে হিসাব কষা সম্ভব হয়ে উঠল।
৪. প্রায়োগিক বিজ্ঞানের যুগ
এই পরিসংখ্যানিক বিপ্লব এআই-কে অলীক কল্পনা থেকে একটি কঠিন ও বাস্তবমুখী প্রকৌশলে রূপান্তর করল। স্পিচ রিকগনিশনে হিডেন মার্কভ মডেল (HMM), সম্ভাবনা গণনায় বায়েশিয়ান নেটওয়ার্ক এবং ক্লাসিফিকেশনে এসভিএম বিশ্বব্যাপী একচ্ছত্র আধিপত্য বিস্তার করল। কিন্তু এরই মাঝে নিউ ইয়র্কের এক বহুতল ভবনে রচিত হচ্ছিল যন্ত্রের এক ঐতিহাসিক বিজয়—বিশ্ব দাবা চ্যাম্পিয়ন গ্যারি কাসপারভের পতন।