২০২২ সালের শেষ নাগাদ প্রাক-প্রশিক্ষিত ফাউন্ডেশন মডেলগুলো মানুষের যেকোনো টেক্সট বা চিত্র অবিশ্বাস্য নিখুঁতভাবে অনুকরণ করতে পারছিল। তবে এই রিলিজ-পূর্ব মডেলগুলো প্রায়শই মিথ্যা তথ্য উদ্ভাবন (hallucination), বিষাক্ত ভাষা বা প্ররোচনামূলক উত্তরে পথভ্রষ্ট হতো। এই কাঁচা বুদ্ধিমত্তাকে জনকল্যাণমুখী, নির্ভরযোগ্য এবং সুশৃঙ্খল চিন্তাশীল সংলাপে রূপান্তর করার প্রক্রিয়াই হলো অ্যালাইনমেন্ট (Alignment), যা বিশ্বজুড়ে ঐতিহাসিক জেনারেটিভ এআই বিপ্লবের বিস্ফোরণ ঘটায়।
১. বুদ্ধিমত্তাকে সুশৃঙ্খল করা: আরএলএইচএফ (RLHF)
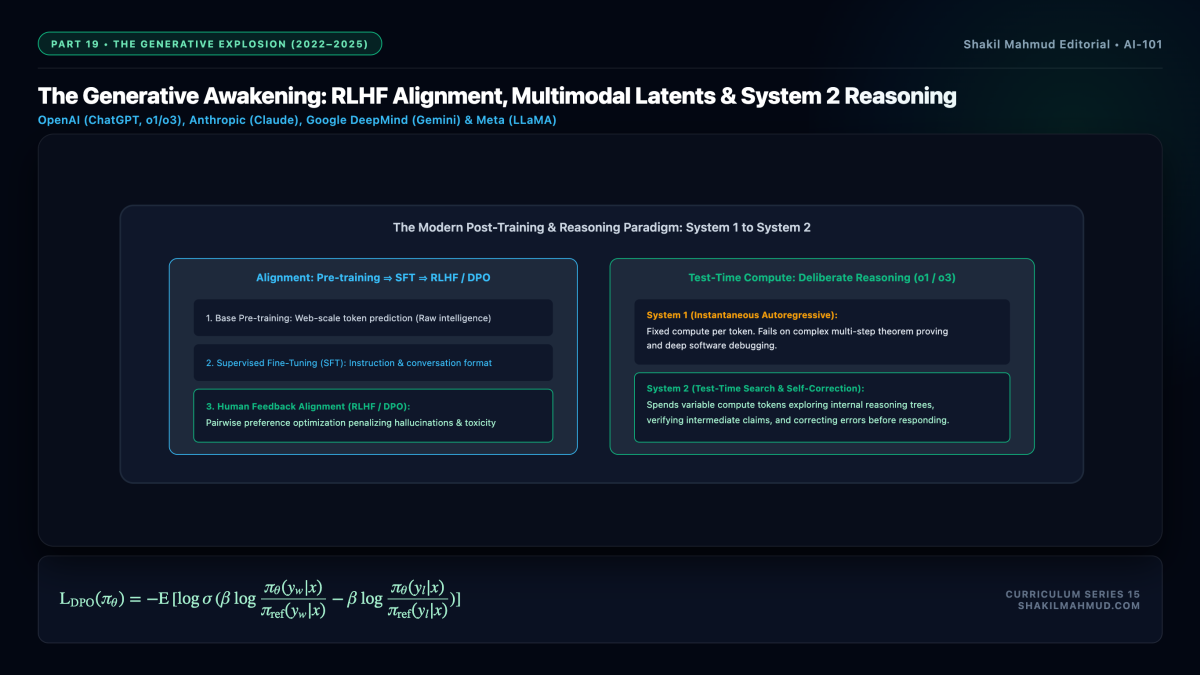
একটি এলোমেলো পরবর্তী-শব্দ অনুমানকারী ইঞ্জিনকে অনুগত ও সহায়ক অ্যাসিস্ট্যান্টে রূপান্তর করতে ব্যবহৃত হয় আরএলএইচএফ (RLHF) পদ্ধতি। এর তিনটি প্রধান ধাপ রয়েছে:
- সুপারভাইজড ফাইন-টিউনিং (SFT): উচ্চমানের মানবিক কথোপকথনের ডেটাসেটে মডেলটিকে প্রাথমিক শিষ্টাচার ও বিন্যাস শেখানো।
- রিওয়ার্ড মডেল প্রশিক্ষণ: ব্র্যাডলি-টেরি প্রেফারেন্স মডেল ব্যবহার করে মানুষের পছন্দ ও রেটিংয়ের ওপর ভিত্তি করে একটি স্কোরিং ফাংশন $r_phi(x, y)$ তৈরি করা:
$$P(y_1 succ y_2 mid x) = sigma(r_phi(x, y_1) – r_phi(x, y_2))$$
- পিপিও অপ্টিমাইজেশন: প্রক্সিমাল পলিসি অপ্টিমাইজেশনের মাধ্যমে মডেলটিকে সর্বোচ্চ রিওয়ার্ড অর্জনে উৎসাহিত করা, সাথে কুলব্যাক-লেইবলার (KL) ডাইভারজেন্স পেনাল্টির মাধ্যমে মূল মডেল থেকে অতিরিক্ত বিচ্যুত হওয়া ঠেকানো:
$$max_theta mathbb{E}_{(x, y) sim mathcal{D}}left[r_phi(x, y)right] – beta D_{KL}left(pi_theta(y mid x) parallel pi_{text{ref}}(y mid x)right)$$
এই কেএল ডাইভারজেন্স পেনাল্টি মডেলকে রিওয়ার্ড মডেলের ত্রুটির অপব্যবহার করা থেকে বিরত রাখে। ২০২২ সালের নভেম্বরে এই প্রযুক্তিতে তৈরি চ্যাটজিপিটি (ChatGPT) গোটা বিশ্বকে প্রযুক্তিগত বিপ্লবের মুখোমুখি করে।
২. ডিরেক্ট প্রেফারেন্স অপ্টিমাইজেশন (DPO)
পিপিও শক্তিশালী হলেও জিপিইউ মেমরিতে একই সাথে একাধিক মডেল পরিচালনা করা অত্যন্ত জটিল ও অস্থিতিশীল ছিল। ২০২৩ সালে রাফাইলভ প্রমুখ উদ্ভাবন করেন ডিরেক্ট প্রেফারেন্স অপ্টিমাইজেশন (DPO)। তাঁরা প্রমাণ করেন যে রিওয়ার্ড মডেল ছাড়াই সরাসরি মূল মডেলের সম্ভাব্যতার তুলনা করে একটি সহজ বাইনারি ক্রস-এনট্রপি লসের মাধ্যমে অপ্টিমাইজেশন সম্ভব:
$$mathcal{L}_{text{DPO}}(theta; pi_{text{ref}}) = -mathbb{E}_{(x, y_w, y_l)}left[log sigmaleft(beta log frac{pi_theta(y_w mid x)}{pi_{text{ref}}(y_w mid x)} – beta log frac{pi_theta(y_l mid x)}{pi_{text{ref}}(y_l mid x)}right)right]$$
ডিপিও ওপেন-সোর্স কমিউনিটিতে এলএলএম অ্যালাইনমেন্টকে কয়েক গুণ দ্রুত, স্থিতিশীল ও সহজলভ্য করে তোলে।
৩. ডিফিউশন মডেল ও চাক্ষুষ সৃজনশীল বিপ্লব
ভাষার সমান্তরালে দৃশ্যমান চিত্র তৈরিতে আসে ডিফিউশন মডেল (Diffusion Models)। গ্যানের (GAN) প্রতিদ্বন্দ্বিতামূলক প্রশিক্ষণ বাদ দিয়ে এটি তাপগতিবিদ্যার স্টোকাস্টিক ডিফারেনশিয়াল সমীকরণের ধারণায় কাজ করে। বিশুদ্ধ গাউসিয়ান নয়েজ থেকে ধাপে ধাপে নয়েজ বিয়োগ করে তৈরি হয় মিডজার্নি, স্টেবল ডিফিউশন বা ফ্ল্যাক্সের মতো বিস্ময়কর ফটোরিয়ালিস্টিক শিল্পকর্ম।
৪. সিস্টেম-১ বনাম সিস্টেম-২ রিজনিং ও টেস্ট-টাইম কম্পিউট
সাধারণ এলএলএম ড্যানিয়েল কানেম্যানের সিস্টেম-১ চিন্তার মতো কাজ করে—তাৎক্ষণিক ও অপরিবর্তনীয় গতিতে প্রতিটি টোকেন তৈরি করে। ফলে জটিল গণিত বা লজিকে এটি প্রায়ই ভুল করে।
এই সীমাবদ্ধতা ভাঙতে আসে চেইন-অব-থট (Chain-of-Thought) এবং টেস্ট-টাইম সার্চ। সিদ্ধান্ত গ্রহণের সময় অতিরিক্ত কম্পিউট ব্যয় করে মডেলটি আত্ম-পর্যালোচনা, ব্যাকট্র্যাকিং এবং ট্রি সার্চের মাধ্যমে চিন্তাভাবনা সম্পন্ন করে। ওপেনএআই-এর o1 ও o3 মডেলের মাধ্যমে এআই প্রবেশ করেছে সিস্টেম-২ সুচিন্তিত যুক্তিবাদ-এর যুগে, যা আন্তর্জাতিক অলিম্পিয়াড পর্যায়ের গণিত ও বৈজ্ঞানিক সমস্যা সমাধানে মানুষের সমকক্ষ হয়ে উঠেছে।